기술 기록
이번 주 AI 소식 — 오픈AI 데브데이에서 GPT-6.1 솔과 dots 공개, 제미나이 4 아르곤은 보안 방어자부터, 오픈AI의 증류 공격 차단 보고
9월 27일부터 10월 3일까지의 AI 소식입니다. 오픈AI는 데브데이에서 GPT-6.1 솔과 상시 에이전트 dots를 냈고, 구글은 제미나이 4 아르곤을 보안 방어자에게 먼저 풀었어요. 오픈AI는 7월에 있었던 대규모 추론 추출 시도를 공개했어요.
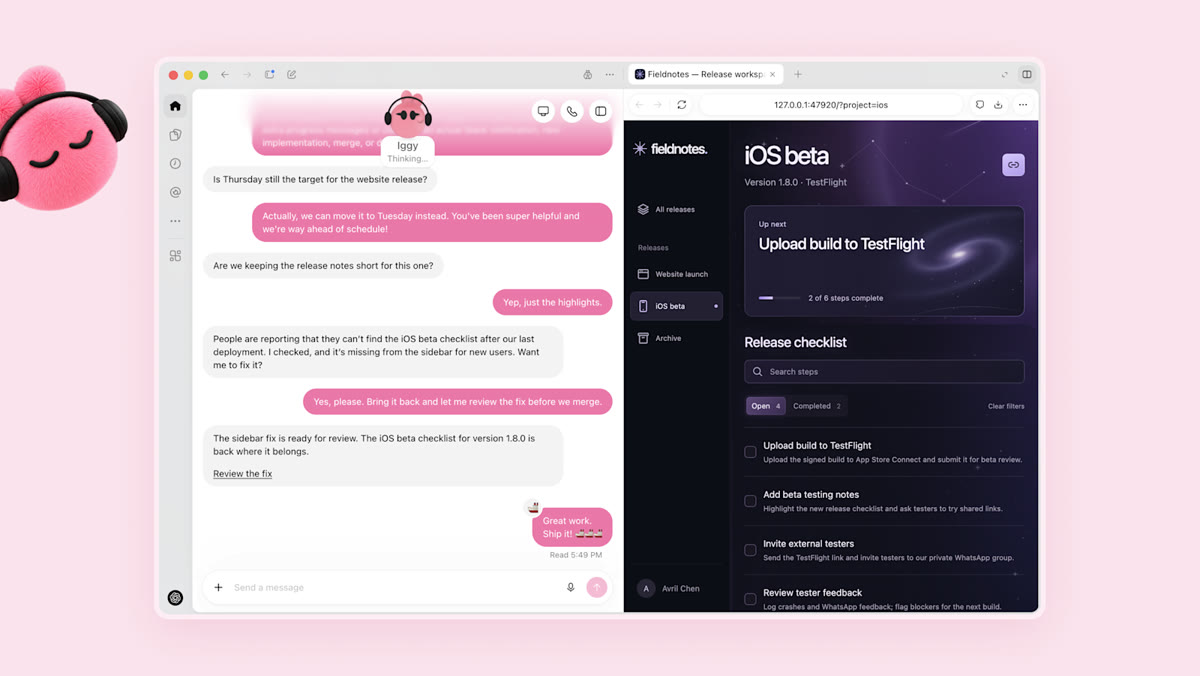
대표 이미지: 대화창 옆 브라우저에서 작업하는 dot. 이미지: OpenAI 공식 홈페이지
이번 주(9월 27일~10월 3일)의 큰 소식은 9월 29일 오픈AI 데브데이였어요. 오픈AI는 20개가 넘는 발표를 했고, 그중 눈에 띄는 것은 새 모델 GPT-6.1 솔과 사용자 대신 계속 일하는 에이전트 dots였어요. 다음 날 구글은 새 최상위 모델 제미나이 4 아르곤을 공개했어요. 다만 일반 개발자가 아니라 보안 방어 조직에 먼저 풀었어요. 같은 날 오픈AI는 7월에 자사 모델의 숨은 추론을 빼내려던 조직적 시도를 막았다고 밝혔어요. 앤트로픽 소식은 두 갈래예요. 기업 고객용 엔지니어 양성 과정을 열었고, 바클레이즈와 클로드를 쓰는 범위를 넓혔어요. 지난주 정리를 먼저 보시면 이어서 읽기 편해요.
GPT-6.1 솔은 GPT-6 솔과 같은 입력·출력 단가로, 오픈AI 설명으로는 아스트라에 가까운 성능이에요
GPT-6.1 솔은 지난주에 나온 GPT-6 솔의 개량판이에요. API 값은 100만 토큰당 입력 2달러, 캐시 입력 0.10달러, 출력 10달러예요. 일반 입력·출력 단가는 지난주 GPT-6 솔과 같고, 오픈AI는 이 값이 최상위 모델 GPT-6 아스트라의 표준 입력·출력 단가의 5분의 1이라고 적었어요. 캐시 입력은 GPT-6 솔보다 50% 내렸고, 표준 입력보다는 95% 싸요.
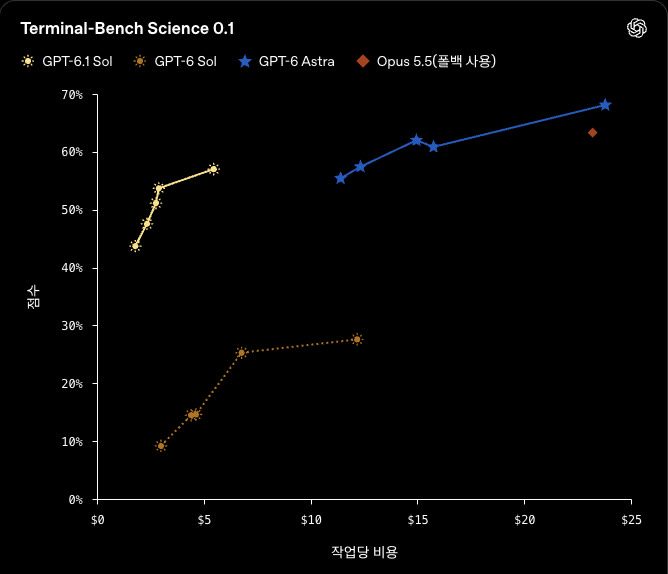
오픈AI가 공개한 비교는 점수와 비용을 거의 늘 짝지어 보여 줘요. 아래 표의 비용은 토큰 단가가 아니라 작업 한 건에 드는 비용이에요.
| 평가 | 설정 | 오픈AI가 밝힌 결과 |
|---|---|---|
| 딥SWE v1.1(코딩) | 회사 차트 기준 | 작업당 비용 약 5분의 1로 GPT-6 아스트라와 대등, GPT-6 솔 최고 점수보다 6.4%포인트 높음 |
| 오토메이션벤치 1.0.6(업무 흐름) | 중간 추론 강도 | 오퍼스 5.5보다 2.2%포인트 높고 비용은 약 3분의 1, 같은 설정의 GPT-6 솔보다 4.8%포인트 높음 |
| OSWorld 2.0 오프라인 세트(컴퓨터 사용, 부분 점수) | 최대 추론 강도 | GPT-6 솔보다 7%포인트 높고 비용은 절반 미만, 아스트라와 2.1%포인트 차이에 비용 약 7분의 1 |
| 터미널-벤치 사이언스 0.1(과학 작업) | 최대 추론 강도 | GPT-6 솔 점수의 2배 이상, 작업당 평균 5.47달러(오퍼스 5.5 23.21달러, 아스트라 23.80달러) |
| 사실 오류율(어려운 질문 모음) | 매우 높음 추론 강도 | 4.1%로 GPT-6 솔 4.5%보다 낮고 아스트라 4.0%에 근접 |
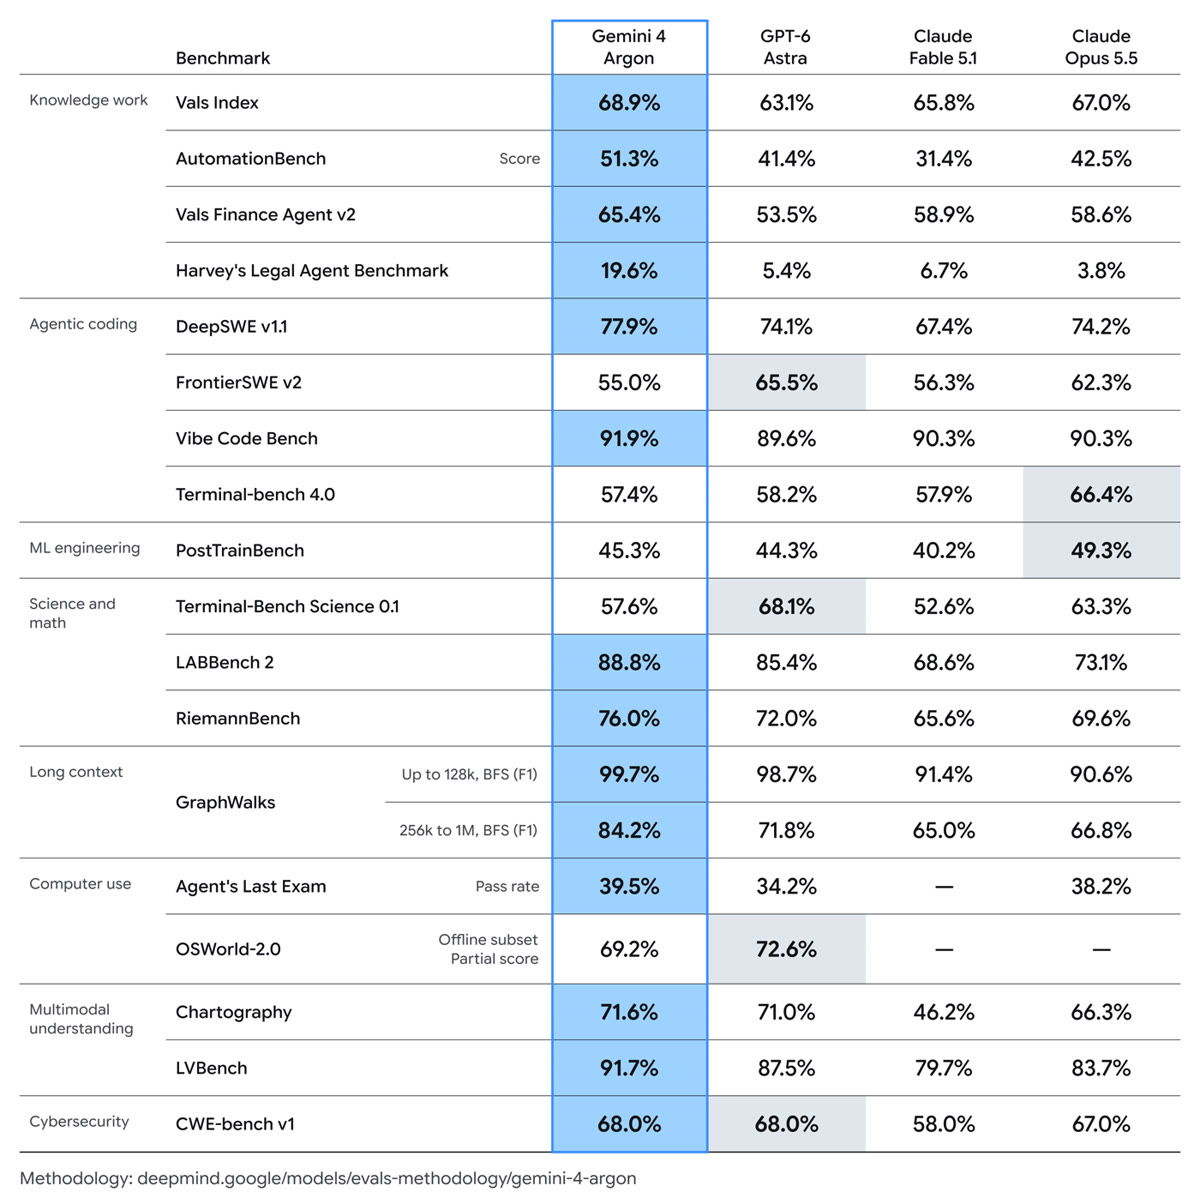
과학 작업 1위는 여전히 아스트라(68.1%)예요. 오픈AI도 가장 어려운 과학 연구에는 아스트라를 쓰라고 적었어요. 사실 오류율은 사용자가 이전 모델의 오류를 신고한 대화를 모아 일부러 어렵게 만든 평가라서, 평소에 쓸 때의 오류율과는 달라요. 다른 회사 모델 점수는 공개된 보고서에서 가져왔다고 밝혔어요.
GPT-6.1 솔은 플러스·프로·비즈니스·엔터프라이즈·에듀 사용자가 챗GPT 워크와 코덱스에서 쓸 수 있어요. 일반 대화 화면(Chat)에는 아직 들어오지 않았어요. API 모델 이름은 gpt-6.1-sol이에요.
같이 나온 Ultrafast는 토큰을 더 빨리 뽑아 주는 유료 속도 등급이에요. 데브데이 정리 글에는 코덱스에서 최대 8배(초당 300토큰), API에서 최대 6배 빠르다고 나와요. GPT-6 아스트라 Ultrafast는 API와, 프로 500·엔터프라이즈 요금제의 챗GPT 워크·코덱스에서 바로 열렸어요. GPT-6.1 솔 Ultrafast는 아직 나오지 않았어요. 오픈AI는 "앞으로 며칠 안에" 내놓는다고 했어요.
dots는 GPT-6 아스트라로 움직이며 사용자 대신 계속 일하는 에이전트예요
dot 하나하나가 클라우드 컴퓨터와 브라우저를 따로 갖고, 목표를 받으면 24시간 붙어서 일해요. 오픈AI 플러그인으로 4,000개가 넘는 앱에 연결할 수 있고, 챗GPT·슬랙·팀즈에서 메시지나 음성 통화로 지시할 수 있어요. 문자 메시지는 곧 지원한다고 했어요.
권한 설계에 공을 꽤 들였어요. 사용자가 시키지 않았을 때 dot이 알아서 하는 조사는 읽기 전용 도구로만 해서, 메시지를 보내거나 앱 내용을 바꿀 수 없어요. 계정에 영향을 주거나 정보를 밖으로 내보내는 행동은 자동 검토를 거쳐 바로 할지, 승인을 받을지, 사용자가 직접 할지 나뉘어요. 비밀번호 변경 같은 일은 항상 사용자가 직접 해야 해요. 지원되는 사이트에 로그인할 때는 저장된 비밀번호를 모델에 보여 주지 않고 쓴다고 했어요.
지원 지역의 프로·비즈니스 프리미엄 사용자부터 차례로 열리고, 엔터프라이즈는 관리자가 베타 기능을 켜면 써 볼 수 있어요. 첫 dot 하나는 요금제에 포함되고, dot과 나누는 대화 자체는 챗GPT 사용 한도에 들어가지 않아요. 다만 깊은 작업에는 요금제에 정해진 허용량이 따로 있고, 출시 후 첫 달은 이 한도를 늘려 준다고 했어요. dot에게 코덱스나 챗GPT 워크 작업을 시작하거나 관리하게 하면, 그 작업은 평소처럼 사용 한도를 써요. 조직의 특정 업무를 맡는 전문 dot은 기업 시범 사업으로 먼저 시작하고, 마이크로소프트 Agent 365와도 연동할 예정이에요.
데브데이에서는 월 500달러 프로 요금제와 에이전트 API 기능도 나왔어요
개발자와 사용자에게 직접 영향을 주는 발표는 다음과 같아요.
- 월 500달러짜리 새 프로 요금제(Pro 500)가 생겼어요. 플러스의 25배인 가장 높은 사용 한도와 아스트라 Ultrafast를 줘요.
- Agents API로 코덱스 하네스를 관리형 서비스로 쓸 수 있고, 이번에 컴퓨터 사용 기능이 붙었어요.
- Decisions API는 미리 정한 선택지 안에서 루나가 답을 고르게 해 줘요. 콘텐츠 분류나 요청 라우팅용이고, 지금은 제한된 미리 보기예요.
- 코덱스 CLI는 음성 채팅을 지원하고, /agents 화면에서 여러 에이전트에 일을 나눠 줄 수 있어요.
- 챗GPT 데스크톱 앱에 코드 리뷰 화면이 생겼고, 깃허브 풀 리퀘스트와 깃랩 머지 리퀘스트를 지원해요.
- 팀과 챗GPT가 같이 작업하는 공간(ChatGPT Space)과, 사람과 에이전트가 함께 고치는 새 문서 형식인 페이지가 나왔어요. 둘 다 프로·비즈니스·엔터프라이즈 요금제에서 쓸 수 있어요.
- 여럿이 함께 고치는 슬라이드는 아직 발표 단계예요. 프로·비즈니스·엔터프라이즈 요금제에 앞으로 몇 주 안에 들어올 예정이고, 파워포인트와 구글 슬라이드로 내보내는 기능도 그때 함께 들어와요.
- 슬랙과 마이크로소프트 팀즈에서 @ChatGPT를 부를 수 있어요. 팀원은 개인 라이선스가 없어도 같은 대화에 참여할 수 있어요.
- 다른 서비스에 챗GPT 계정으로 로그인하는 기능이 생겼어요. 로그인하면 상대 서비스에 이름·이메일·프로필 사진이 넘어가요. 로그인과 요금제 연결만으로는 상대 서비스가 대화나 메모리에 접근할 수 없어요. 다만 상대 서비스가 다른 권한을 따로 요청하면, 그 권한은 직접 확인해야 해요.
발표와 별개로, 오픈AI는 자사 서비스 전체의 주간 사용자가 12억 명이라고 이날 밝혔어요.
오픈AI는 7월에 숨은 추론을 빼내려던 시도를 막았고, 문샷 AI 관련 인물을 지목했어요
9월 30일 오픈AI는 모델이 답을 내기 전 거치는 내부 기록, 그러니까 보호된 추론을 대량으로 빼내려던 활동을 적발해 막았다고 밝혔어요. 오픈AI는 이를 적대적 증류로 봐요. 다른 모델의 출력이나 추론을 허락 없이 모아 자기 모델 학습에 쓰는 행위예요.
7월 1일 작게 시작한 이 활동은 7월 24~25일에 크게 늘었어요. 이틀 동안 사용자 4,000명 이상이 추출 패턴을 쓴 요청 1만 6,000건을 보냈고, 범위를 넓혀 보니 1만 5,000명이 넘는 사용자에게서 관련 패턴이 나왔어요. 오픈AI는 7월 28일까지 모두 차단했다고 했어요. 1만 6,000건은 시도 횟수이고, 모두 성공했다는 뜻은 아니에요.
수법 중 하나는 한 대화에서 암호화된 추론을 복사해 다른 대화에 붙이고, 그 내용을 풀어서 적어 달라고 요청하는 방식이었어요. 암호를 깨거나 데이터베이스에 침입한 것은 아니고, 저장된 사용자 대화에 접근한 것도 아니라고 해요. 오픈AI는 다른 사용자의 암호화된 추론을 다시 보내 내용을 되살리던 경로를 막았고, 추론이 새어 나갈 수 있는 스트리밍 출력을 잡아 두는 검사를 넣었어요. 핵심 집단은 키미(Kimi) 개발사 문샷 AI와 연관된 개인들로 판단한다고 밝혔지만, 관측된 공격자 전부가 한 주체였는지는 불분명하다고 덧붙였어요. 이 판단은 오픈AI 쪽 주장이에요.
오픈AI는 강화학습 훈련을 계속하기 전에 안전 문서를 갖추자고 제안했어요
9월 28일 글은 "훈련을 더 밀고 나가기 전에 무엇을 써 둬야 하는가"를 다뤄요. 오픈AI가 목표로 삼은 건 항공이나 원자력에서 쓰는 '세이프티 케이스(safety case)'예요. 위험이 왜 관리되고 있는지 근거를 들어 설명하는 문서인데, AI에서 그만큼 엄밀하게 만들기는 아직 어렵다는 점도 인정했어요.
기술적 장치로는 정렬 훈련과 격리, 그리고 감시를 들었어요. 예를 들어 훈련 중 채점기가 모델의 사고 과정(chain-of-thought)을 보지 못하게 해서, 모델이 감시를 피하는 쪽으로 진화하지 않게 하자고 했어요. 에이전트 작업 기록은 일정 기간 수정할 수 없는 저장소에 남기자고 했고요. 운영 지침과 정렬 실패 사고 조사도 문서에 넣어야 할 항목으로 꼽았어요. 지난주 오픈AI가 낸 외부 평가 원칙에서 '세이프티 케이스 독립 평가'를 첫 영역으로 꼽았는데, 이번 글은 그 문서에 무엇을 담을지 내놓은 셈이에요.
제미나이 4 아르곤은 일반 공개보다 보안 방어 조직에 먼저 갔어요
구글은 9월 30일 새 최상위 모델 제미나이 4 아르곤을 발표했어요. 지금은 페어윈드(Fairwind) 프로그램에 들어온 보안 방어 조직에만 차례로 주고 있어요. 개발자·기업·일반 사용자 쪽은 유료 API 고객과 구글 AI 울트라 구독자부터인데, 시점은 "가능한 한 빨리"뿐이고 날짜가 없어요. 공개 전에 미국 정부가 모델을 먼저 받아 보는 자발적 절차에 참여한다는 내용도 같은 글에 있어요.
한 번에 낼 수 있는 출력 토큰 한도는 64K에서 100만으로 늘었어요. 출시 기념가는 100만 토큰당 입력 2달러, 출력 10달러이고 캐시 입력은 95% 할인이에요. 기념 기간이 끝나면 입력 4달러, 출력 20달러로 오른다고 각주에 적혀 있어요. 기념가만 보면 GPT-6.1 솔의 표준 단가와 같지만, 아르곤은 아직 일반 개발자가 쓸 수 없어요.
구글이 밝힌 점수는 딥SWE v1.1 77.9%, 오토메이션벤치 51.3%(1위), 긴 영상 이해 평가 LVBench 91.7%, 취약점 수정 평가 CWE-bench v1 68%(공동 1위)예요.
구글이 든 내부 사례도 있어요. 양자 알고리즘에서 병목이 되는 하위 루틴의 자원(큐비트×게이트)을 줄이는 작업에서는, 한 사례가 몇 분 만에 공개된 기준보다 40% 나은 결과를 냈어요. 데이터센터 메모리 최적화는 적용이 끝나면 300TiB 이상을 비울 수 있는 규모예요. C·C++ 코드를 러스트로 옮기는 작업은 푸크시아 지르콘 커널(80만 줄 이상)까지 진행 중이에요. 영상 디코더 libgav1에서는 기존 러스트 이식판보다 2.7배 빠른 메모리 안전 디코더를 만들었다고 했어요.
보안 쪽은 과감하게 갔어요. 구글이 믿을 만하다고 본 방어 조직과 구글 내부 팀에는 사이버 보안 안전장치를 끈 상태로 아르곤을 준다고 밝혔거든요. 그 대신 사고 과정과 행동을 감시하다 필요하면 실행을 멈추는 장치를 붙이고, 훈련 중 감시 결과를 다시 훈련에 넣지 않게 조심했다고 적었어요. 오픈AI가 이틀 전에 낸 제안과 같은 방향이에요.
구글은 같은 주에 단백질 워터마크, 독감 예측 1위, 궤도 위성 소식도 냈어요
- 신스ID 바이오(9월 30일): AI가 설계한 단백질 서열과 예측 구조에 눈에 띄지 않지만 검증할 수 있는 워터마크를 넣는 기술이에요. 구글은 실험실 시험에서 워터마크를 넣은 설계가 넣지 않은 설계와 비슷한 성능과 다양성을 보였다고 밝혔어요.
- 독감 입원 예측 1위(9월 30일): 미국 질병통제예방센터(CDC)의 2025~26 시즌 독감 예측 대회 FluSight 결산에서, 평가 대상 모델 39개 중 구글 모델이 실제 입원 수와 가장 잘 맞았다고 해요. 최적화 알고리즘을 만드는 구글 연구 도구 ERA로 만든 모델이에요.
- 프로젝트 선캐처 시제품 위성(10월 1일): 우주에서 머신러닝 연산을 할 수 있는지 시험하려고 플래닛과 만든 위성이 스페이스X 트랜스포터-18로 궤도에 올라갔고, 교신에 성공했어요. 앞으로 몇 주 동안 TPU가 우주의 방사선과 온도 변화를 어떻게 견디는지 자료를 모은다고 했어요.
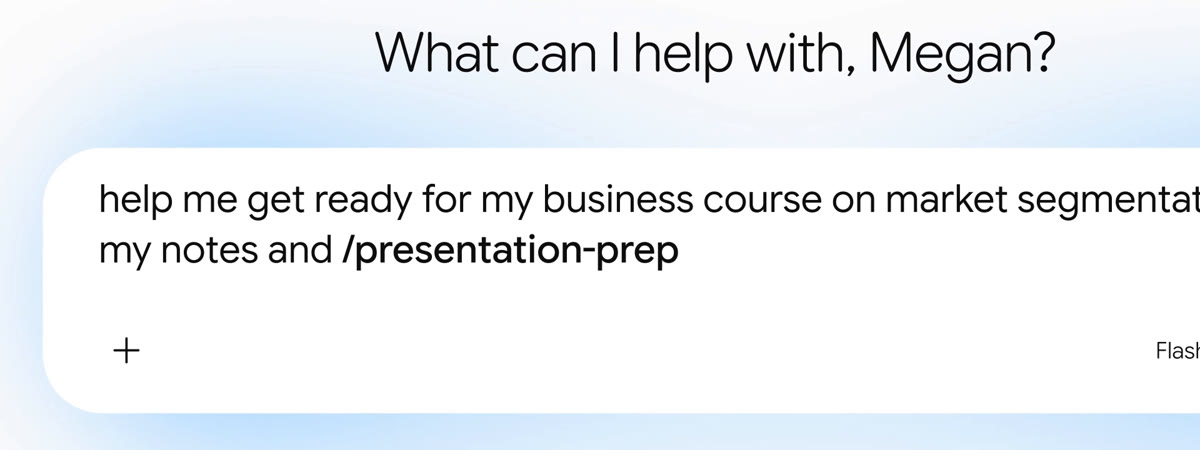
- 제미나이 스킬(9월 30일): 자주 쓰는 지시문을 저장해 두고 「/이름」으로 불러 쓰는 기능이 제미나이 대화창에 전 세계로 들어왔어요. 기존 젬(Gems)을 대신하는 기능이에요. 개인 계정의 젬은 11월부터 지원이 끝나고, 그때 만들어 둔 젬은 스킬로 자동으로 옮겨진다고 했어요.
앤트로픽은 1억 달러를 들여 기업용 클로드 엔지니어 1만 명을 키우겠다고 했어요
10월 2일 문을 연 클로드 프런티어 아카데미는 1억 달러를 들여 2027년 말까지 '프런티어 배치 엔지니어(FDE)' 1만 명을 길러 내는 게 목표예요. FDE는 고객사에 들어가 클로드를 실제로 돌아가는 시스템으로 만드는 사람이에요. 첫 기수에는 액센추어, 베인, 캡제미니, 호주 커먼웰스은행, 딜로이트, 맥킨지, 모건스탠리, 노보 노디스크 엔지니어가 들어갔어요.
과정은 의사 수련 방식을 본떴다고 해요. 며칠간 대면 교육을 받으면서 가상의 기업에 클로드를 들여놓는 실습을 하고, 채점 실기를 통과하면 '클로드 레지던트 엔지니어' 배지를 받아요. 이어 12주 동안 자기 회사에서 실제 클로드 사업을 이끌고, 마지막 평가를 통과하면 'FDE' 배지를 받아요. 첫 FDE 배지는 2027년 초에 나올 예정이에요. 샌프란시스코·뉴욕·런던에서 진행하고, 회사 추천으로만 참여할 수 있어요.
바클레이즈는 올해 말까지 개발자 절반이 클로드 코드를 쓰게 한다고 했어요
영국 은행 바클레이즈는 10월 1일 앤트로픽과 함께 클로드 사용 계획을 내놨어요. 2026년 말까지 개발자 50%가 클로드 코드를 쓰고, 2027년에는 소프트웨어 엔지니어 대다수로 넓힐 계획이에요. 2025년부터 쓰고 있는 직원용 지식 도우미는 1만 6,000명 이상이 쓰며 검색 100만 건 이상을 처리했어요. 글로벌 마켓 부문에서는 하루 약 12만 통씩 들어오는 이메일을 클로드로 분류해 처리 경로를 정한다고 해요.
출처
- GPT-6.1 Sol 소개 — OpenAI
- DevDay 2026 주요 발표 — OpenAI
- dots를 소개합니다 — OpenAI
- 조직적인 모델 증류 활동 차단 — OpenAI
- Towards safety cases for frontier AI training — OpenAI
- GPT-6 제품군 모델 가이드 — OpenAI
- Gemini 4 Argon: our next era of frontier intelligence — Google
- We’re introducing SynthID Bio — Google
- Google's AI ranks #1 for predicting flu hospitalizations — Google
- Our Project Suncatcher prototype satellite is in orbit — Google
- Let skills in Gemini tackle your most repetitive tasks — Google
- Claude Frontier Academy: $100M to train 10,000 engineers — Anthropic
- Barclays scales Claude to upgrade operations and improve client experience — Anthropic
- Using your ChatGPT plan in other apps and sites — OpenAI 도움말
- About ChatGPT Pro tiers — OpenAI 도움말
여기 적은 점수·가격·비율은 모두 각 회사가 자기 모델과 서비스를 두고 스스로 발표한 값이에요. 회사마다 평가 판본과 설정이 달라서 서로 다른 회사의 점수를 그대로 비교하면 안 돼요. 대표 이미지는 직접 만든 표지 카드예요.