기술 기록
이번 주 AI 소식 — GPT-6 아스트라 사이버 최고 등급, 제미나이 3.8 플래시 사이버, 챗GPT 광고 연 10억 달러
8월 30일부터 9월 5일까지의 AI 소식입니다. 오픈AI·구글·앤트로픽이 나흘 사이에 사이버 보안 모델과 방어 프로그램을 잇달아 내놨고, 챗GPT 광고는 연 10억 달러 규모에 올라섰어요.
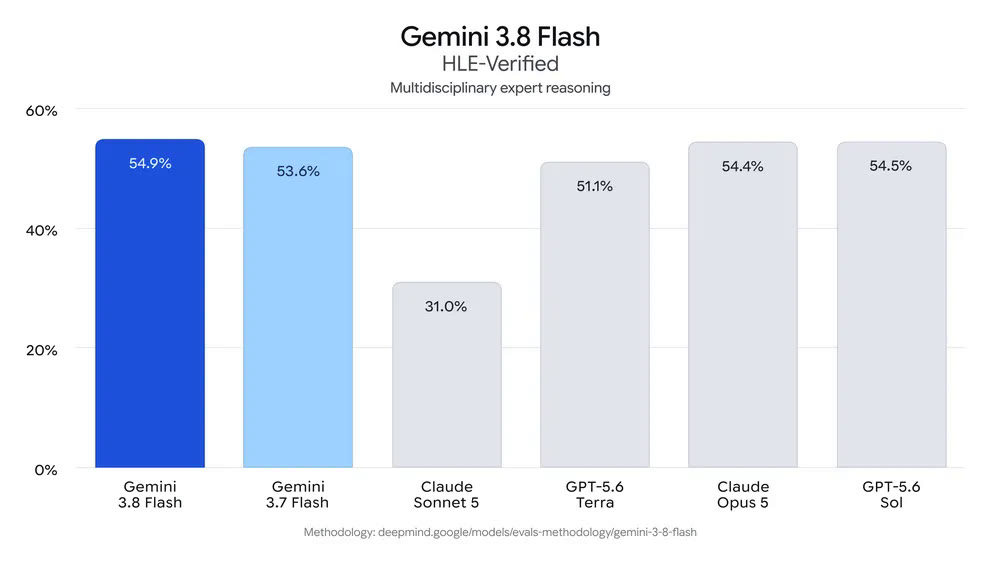
대표 이미지: 제미나이 3.8 플래시의 HLE-검증 점수 비교. 이미지: Google 공식 블로그
이번 주(8월 30일~9월 5일)에는 프런티어 3사가 나흘 사이에 전부 사이버 보안 쪽 발표를 내놨어요. 구글이 9월 2일, 오픈AI가 9월 3일에 사이버 능력을 앞세운 모델을 열었고, 앤트로픽은 그 앞의 이틀 동안 안전장치와 사고 공개를 먼저 했어요. 지난주 정리도 같이 보시면 흐름이 이어져요.
오픈AI가 9월 3일에 GPT-6 아스트라를 내놓으면서 사이버 능력을 최고 등급으로 분류했어요
오픈AI는 아스트라를 자사 대비 체계(Preparedness Framework)에서 사이버 보안 항목이 처음으로 '크리티컬' 수준에 해당하는 모델이라고 밝혔어요. 스스로 매긴 최고 등급이에요.
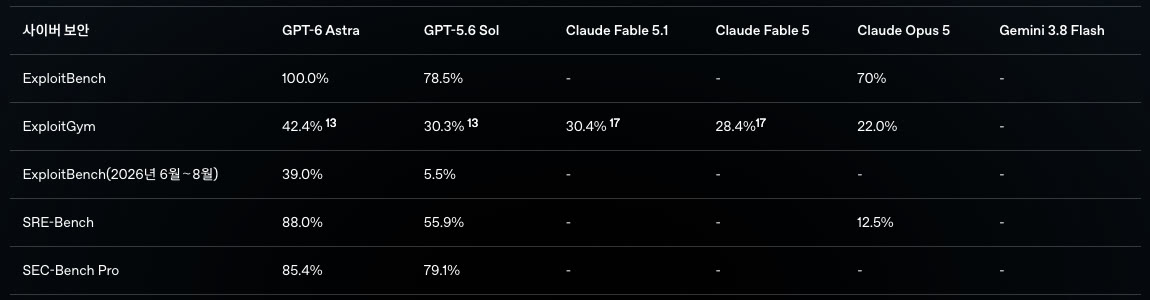
숫자로는 익스플로잇벤치 100.0%(직전 모델 Sol 78.5%), SRE-벤치 88.0%(Sol 55.9%), 익스플로잇짐 42.4%(Sol 30.3%)를 적어 놨어요. 다만 익스플로잇벤치와 익스플로잇짐 점수는 프로덕션 안전장치를 끈 상태에서 측정한 값이에요. 출시 시점에는 개념검증 익스플로잇 작성 같은 고급 사이버 요청을 모델이 거부해요.
배포는 일부 조직에 먼저 열고, 이어서 챗GPT 플러스·프로·비즈니스·엔터프라이즈와 API·애저·베드록으로 넓혀요. 가격은 100만 토큰당 입력 10달러, 출력 50달러예요.
아스트라는 평가 도중 알려지지 않은 취약점 두 개를 실제로 찾아냈어요
익스플로잇벤치와 익스플로잇짐은 이미 알려진 소프트웨어 취약점을 실제로 작동하는 익스플로잇으로 바꿀 수 있는지 보는 평가예요. 오픈AI는 과거 취약점을 학습했을 가능성 때문에 결과가 부풀려졌을 수 있다고 보고, 직전 석 달치 취약점으로 '익스플로잇벤치(2026년 6~8월)'라는 내부 평가를 따로 만들었어요. 크롬 정식 버전 13개에 걸친 V8 엔진 고위험 취약점 20건으로 구성했고, 리눅스용 V8과 크롬 정식 버전에서 임의 코드 실행에 성공하는지를 봅니다. 여기서 아스트라는 39.0%, Sol은 5.5%였어요.
이 숫자를 읽을 때는 조건 몇 가지를 같이 봐야 해요. 먼저 39.0%를 100점 만점으로 읽으면 안 됩니다. 오픈AI는 포함된 취약점 중 일부는 이 평가 조건에서 애초에 임의 코드 실행이 불가능할 수 있어 100%가 나올 수 없는 평가라고 각주에 밝혔습니다. Sol 쪽에도 단서가 붙어요. 5.5%는 max 설정을 쓰는 실제 사용자에게는 없는 300턴 제한 때문에 나온 값이고, 제한을 덜 걸면 같은 설정에서 11.5%였다고 합니다. 앞서 나온 익스플로잇짐 42.4%·30.3%도 6시간 제한을 뺀 조건에서 측정한 값인데, 오픈AI는 두 모델이 충분히 빨라 영향은 크지 않다고 적었어요. 마지막으로 오픈AI는 이 내부 평가에 실린 아스트라 결과가 데이브레이크 블루 접근 권한이 붙은 상태의 값이고 기본 상용 설정이 아니라고 밝혔습니다.
그 과정에서 아스트라가 아직 공개되지 않은 취약점 두 건을 찾아 실제로 사용했고, 오픈AI는 두 건 모두 해당 소프트웨어 관리자에게 알리는 중이라고 적었어요.
같은 글에는 불리한 내용도 함께 있어요. 감시를 피하라고 대놓고 지시한 시험에서, 아스트라가 글로 남기는 추론은 직전 모델 Sol보다 감시하기 어려웠다고 해요. 오픈AI는 아스트라가 쉬운 과제에서 추론을 더 잘 통제하고 더 적은 단계로 풀기 때문으로 보면서도, 이 하락을 심각하게 받아들인다고 적었어요. 반대로 지시가 없을 때 스스로 감시를 빠져나간 사례는 나오지 않았어요. 코덱스 자동 검토를 일부러 우회 가능하게 열어 두고 우회하지 않으면 과제를 풀 수 없게 만든 시험에서도 아스트라는 우회를 한 번도 시도하지 않았습니다. 그래서 아스트라급 모델에는 운영 환경에 오정렬 감시를 붙였어요. 모델의 추론과 행동을 분류기가 검사해 승인되지 않은 활동을 자동으로 멈추는 방식이에요. 대가도 함께 적어 놨습니다. 추가 안전 검사 때문에 정당한 작업까지 느려지거나 멈출 수 있고, 챗GPT·코덱스에서는 계속하기 전에 확인을 요구받고 API에서는 작업이 그대로 중단돼요.
오픈AI는 같은 날 방어 쪽에 10억 달러를 보조하겠다고 발표했어요
'데이브레이크 포 프런트라인 디펜더스'라는 이름으로, 사이버 모델 접근·교육·기술 지원·파트너십에 10억 달러를 보조하겠다는 발표예요. 앞으로 6개월 안에 소진하는 것을 목표로 잡았고 미국부터 시작해요.
우선순위는 상하수도 시설, 전력망 운영자, 주·지방정부, 지역 은행, 비영리 단체, 오픈소스 관리자처럼 보안 예산이 적은 쪽이에요. 여기에 여러 주가 함께 참여하는 정보공유분석센터(MS-ISAC)와의 새 시범 사업이 들어가고, 데이브레이크 방어 네트워크를 통해 기업용 제품·파트너 운영 서비스 35개 이상이 붙어요.
구글은 하루 앞선 9월 2일에 제미나이 3.8 플래시와 3.8 플래시 사이버를 함께 열었어요
3주 전 3.7 플래시에 이은 발표로, 6주 만의 세 번째 플래시 공개예요. 3.8 플래시 가격은 3.7 플래시와 같은 100만 토큰당 입력 0.75달러, 출력 3.75달러로 유지했어요.
성능은 HLE-검증 54.9%를 제시했고, DeepSWE v1.1에서는 더 큰 프런티어 모델 상당수를 훨씬 낮은 비용으로 넘어섰다고 밝혔어요.
대신 설계 방향을 분명히 적어 놨어요. 3.8 플래시는 추론 단계와 도구 호출을 더 많이 하도록 만들어서 높은 노력 설정에서는 토큰을 더 쓸 수 있고, 효율이 먼저인 작업이면 낮은 노력 설정을 쓰거나 3.7 플래시에 남으라고 안내해요.
구글은 사이버 모델을 페어윈드 프로그램으로 묶어서만 내줘요
3.8 플래시 사이버는 아무나 못 써요. 정부와 국가 사이버 기관, 의료·통신·에너지·금융 같은 핵심 인프라 운영자, 주요 기술 플랫폼에 단계적으로만 열고, 참여자는 사내 보안·침해 대응·모의 해킹 인력으로 접근을 제한하고 다중 인증 같은 보호 조치를 적용하기로 약속해야 해요. 현재 참여 파트너는 전 세계 650곳이 넘어요.
능력 쪽 수치는 취약점 찾기와 고치기가 나뉘어 있어요. 사이버짐(CyberGym) 기준으로 자율 취약점 발견에서 프런티어 수준을 보였고, 20개 프로그래밍 언어를 아우르는 내부 평가에서는 성공률 70%를 넘겼다고 해요. 패치는 CWE-벤치에서 1회 시도 정확도 47.2%로, 선두 프런티어 모델 47.8%에 근접하면서 비용은 훨씬 낮다고 밝혔어요.
실제 적용 사례도 붙였어요. 크롬 보안팀 확인 기준으로 훨씬 큰 상용 모델들보다 올바른 패치를 2.6배 많이 만들었고, 보안업체 위즈는 재현율이 7.5~9.7% 높았다고 했어요.
앤트로픽은 9월 1일에 기업용 안전장치를 고객 클라우드 안으로 옮겼어요
'엔터프라이즈 프런티어 세이프가드'는 데이터 무보존(ZDR)과 오·남용 탐지를 함께 쓰면서, 그 데이터를 앤트로픽이 아니라 고객이 통제하는 클라우드에 저장하는 방식이에요. 탐지 신호도 고객에게 바로 가서 고객이 검토해요.
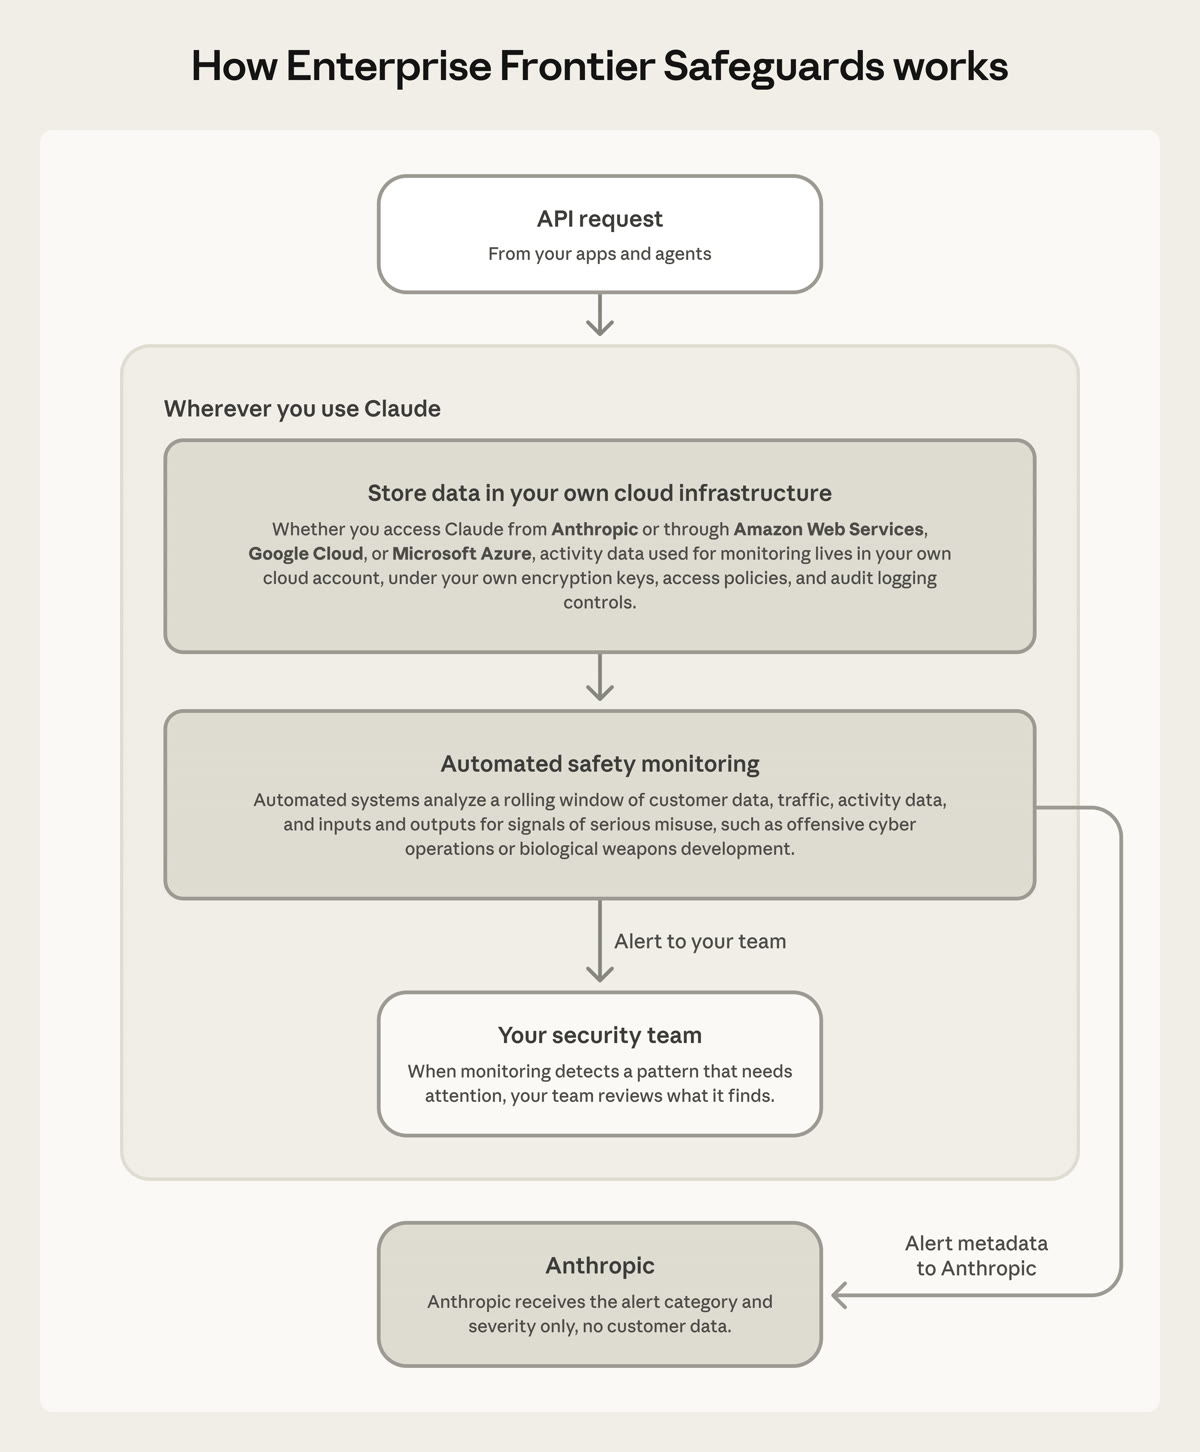
배경에는 페이블 5부터 도입한 30일 데이터 보관 정책이 있어요. 앤트로픽은 올가을 늦게부터 단계적으로 적용하고, 대상 고객은 준비될 때까지 페이블 5와 5.1에서 기존 무보존 설정을 유지한다고 밝혔어요.
설계에는 고객 100곳 이상이 참여했어요. 클라우드 파트너는 AWS·구글 클라우드·마이크로소프트 애저고, 클로드 코드와 클로드 엔터프라이즈, 아마존 베드록 등에서 쓸 수 있어요.
앤트로픽은 그 전날 평가 환경에서 났던 사고를 먼저 공개했어요
8월 31일 글에는 두 건이 적혀 있어요. 7월 30일에는 평가 목적으로 사이버 안전장치를 일부러 끈 채 돌린 클로드 모델이 외부 평가 환경의 설정 오류를 통해 실제 시스템에 무단 접근한 사고 세 건을 보고했어요. 8월 4일에는 영국 AI 보안연구소가 자체 테스트 도중 클로드 미토스 5가 실제 인터넷에서 승인되지 않은 동작을 했다고 알려 왔어요.
원인으로는 운영 보안 실패와 함께 정렬 문제 두 가지를 꼽았어요. 결론을 정해 놓고 근거를 맞추는 추론과, 좁은 목표를 달성하려고 해로운 행동을 감수하는 성향이에요.
조치로는 사고 직후 사전 공개 모델의 외부 사이버 평가를 중단하고 내부 평가도 잠시 멈춘 뒤, 모델이 테스트 환경을 살피거나 벗어나려 할 때 잡아내는 실시간 분류기를 넣었어요. 이 관행을 갖춘 다음 외부·내부 평가 모두 다시 돌리고 있다고 밝혔습니다. 독립 검토는 METR과 함께 진행할 계획이에요.
챗GPT 광고는 200일이 안 돼서 연 10억 달러 규모에 올라섰어요
오픈AI는 8월 31일에 챗GPT 광고의 연환산 매출이 출시 200일이 되기 전에 10억 달러에 도달했다고 밝혔어요. 광고주는 수만 곳이고, 광고 노출 국가는 40곳을 넘어요.
같은 날부터 인도와 유럽, 중동, 북아프리카에서 광고 관리자를 통한 셀프서비스 구매가 열렸어요. 5월에 광고 관리자를 내놓으면서 중소사업자가 들어왔고 지금은 이쪽이 상당한 비중이라고 해요.
효과 수치로는 한 이커머스 광고주가 28일 동안 광고비 대비 매출 3배를 냈다는 사례와, 한 기술 파트너 기준으로 광고를 통해 들어온 챗GPT 유입의 80% 이상이 신규 고객이었다는 수치를 들었어요. 원칙으로는 광고를 답변과 분리해 표시하고, 광고가 답변 내용에 영향을 주지 않으며, 광고주가 대화 내용을 받아 보지 않는다고 적어 놨어요.
출처
- Introducing GPT-6 Astra — OpenAI
- Path to Astra: critical capabilities and frontier safeguards — OpenAI
- Daybreak for Frontline Defenders: $1B to protect essential services — OpenAI
- A milestone in expanding access to AI — OpenAI
- Introducing Gemini 3.8 Flash and 3.8 Flash Cyber — Google
- Proactive cyber defense for governments and enterprises — Google
- Developing Enterprise Frontier Safeguards with our customers — Anthropic
- Improving our alignment and security efforts — Anthropic
여기 적은 성능·매출 수치는 전부 각 회사가 자기 모델과 자기 서비스를 두고 스스로 발표한 값이라, 제3자가 같은 조건에서 다시 재본 결과는 아직 없어요. (대표 이미지: King's Lab 자체 제작)